Update: Meta hapus kata "latih" dari aturan akun bisnisnya. Tapi isi website-mu masih boleh diambil
Setelah diprotes media, Meta mencoret kata "train" dari aturan bisnis yang berlaku 30 Oktober. Izin bot Meta mengambil isi website tetap ada, tanpa tombol menolak. Ini juga koreksi atas tulisan kami sebelumnya.
oleh Tim Otaknologi, pagi ini 12.45 · 3 mnt baca
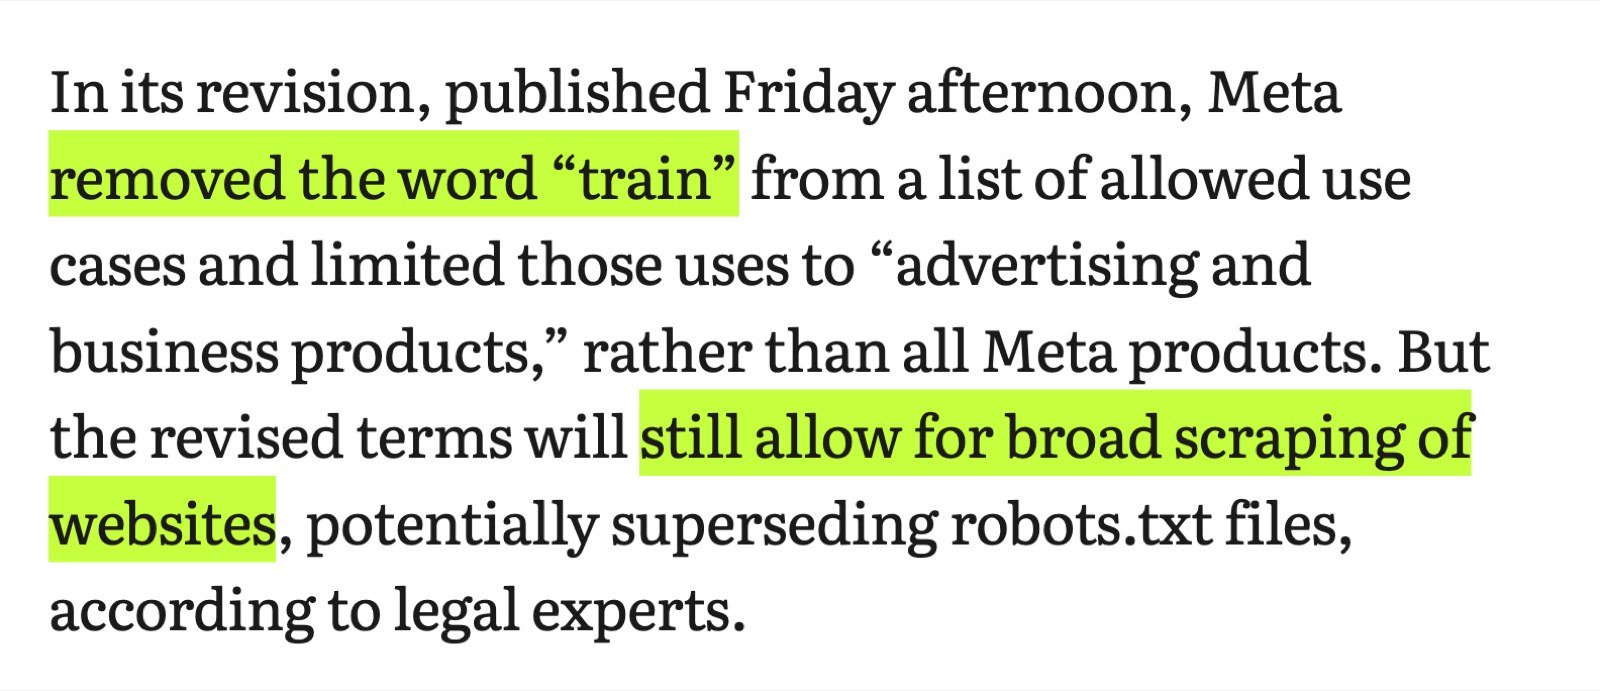
Hari Sabtu kami menulis bahwa aturan bisnis Meta yang berlaku 30 Oktober memberi izin Meta memakai isi website yang terkait akun bisnismu untuk melatih produknya. Ternyata pada Jumat sore waktu Amerika, beberapa jam sebelum tulisan kami terbit, Meta merevisi aturan itu. Kata "train" alias melatih dicoret. Jadi kalimat "boleh dipakai latih AI" di tulisan kami sebelumnya sudah tidak sesuai dengan versi terbaru Meta. Ini koreksinya, sekaligus kabar lanjutannya.
Apa yang diubah Meta
Menurut Nieman Lab, situs kajian media dari Universitas Harvard yang pertama kali memberitakan klausul ini, revisi diterbitkan Jumat sore. Meta menghapus kata "train" dari daftar pemakaian yang diizinkan, lalu membatasi pemakaiannya untuk "produk iklan dan bisnis", bukan lagi semua produk Meta.
Meta menjelaskan ke Nieman Lab bahwa aturan soal penjelajahan situs itu memang hanya untuk produk iklan dan bisnis mereka, dan sekarang sudah diperjelas di aturannya. Juru bicara Meta juga bilang revisi dibuat karena di versi awal tidak jelas bahwa pilihan pemilik situs lewat robots.txt tetap dihormati.
Yang tidak berubah
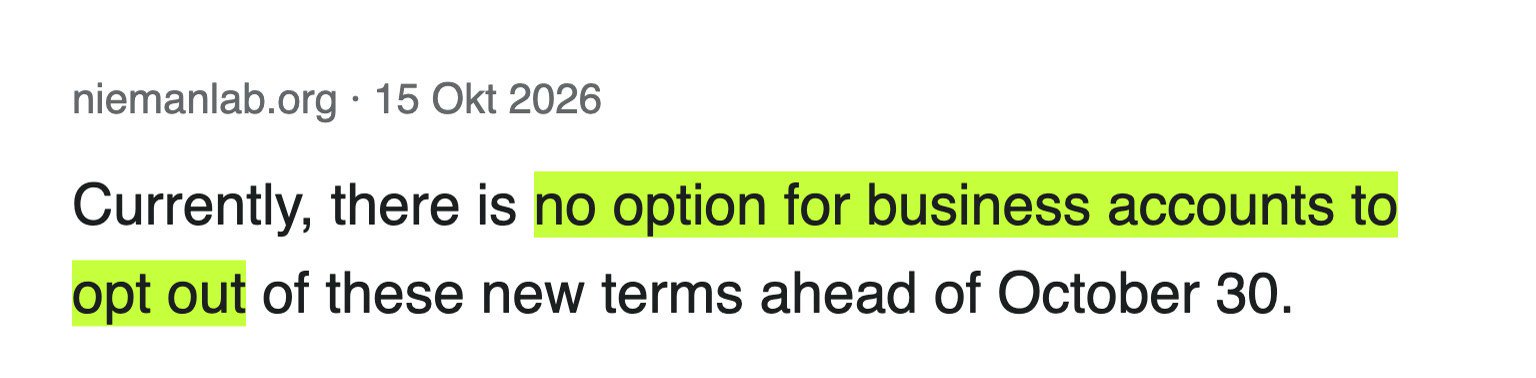
Bagian intinya tetap: dengan memakai fitur bisnis Meta, kamu mengizinkan bot Meta menjelajah dan mengambil isi website yang terkait dengan bisnismu. Dan tetap tidak ada tombol menolak sebelum 30 Oktober.
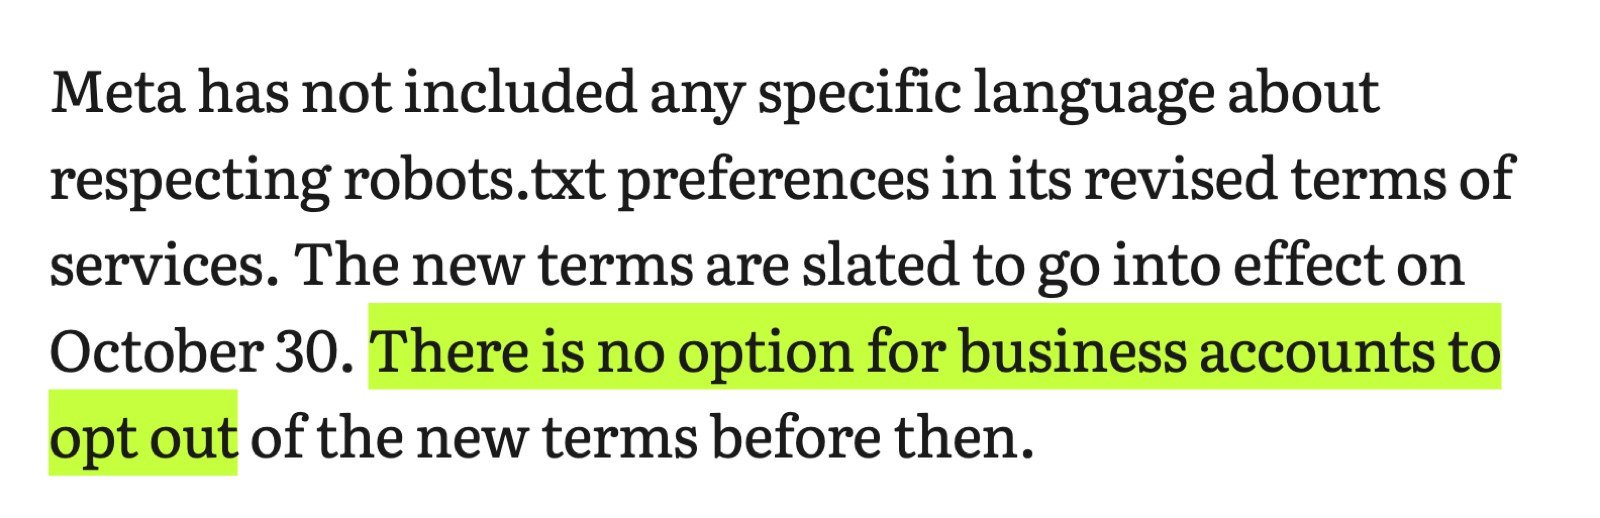
Tiga ahli hukum yang dihubungi Nieman Lab tetap skeptis. James Grimmelmann, profesor hukum Cornell, bilang izin untuk "mengembangkan produk iklan dan bisnis" masih cukup luas untuk dipakai macam-macam, dan revisi ini tidak membatasi bagian "website yang terkait dengan produkmu" yang bisa membuat Meta mengambil seluruh isi situs. Benjamin Sobel dari Universitas Wisconsin mengingatkan bahwa robots.txt hanya menyatakan keinginan pemilik situs. Mematuhinya sukarela.
Ibaratnya pengelola mal mencoret satu kalimat di kontrak sewa, tapi kunci toko utamamu di luar mal tetap ia pegang.
Yang tampil dari Indonesia masih memuat "train"
Ada satu hal yang aneh. Kami membuka halaman aturan versi 30 Oktober dari Indonesia pada Minggu pagi, 18 Oktober, dengan browser yang bersih. Versi yang tampil, bahasa Inggris (Inggris Raya), masih berbunyi: Meta boleh memakai isi dari domain, halaman web, atau alamat itu untuk "provide, develop, improve, research, train and maintain" produk Meta. Versi bahasa Indonesianya juga masih memuat kata "melatih".
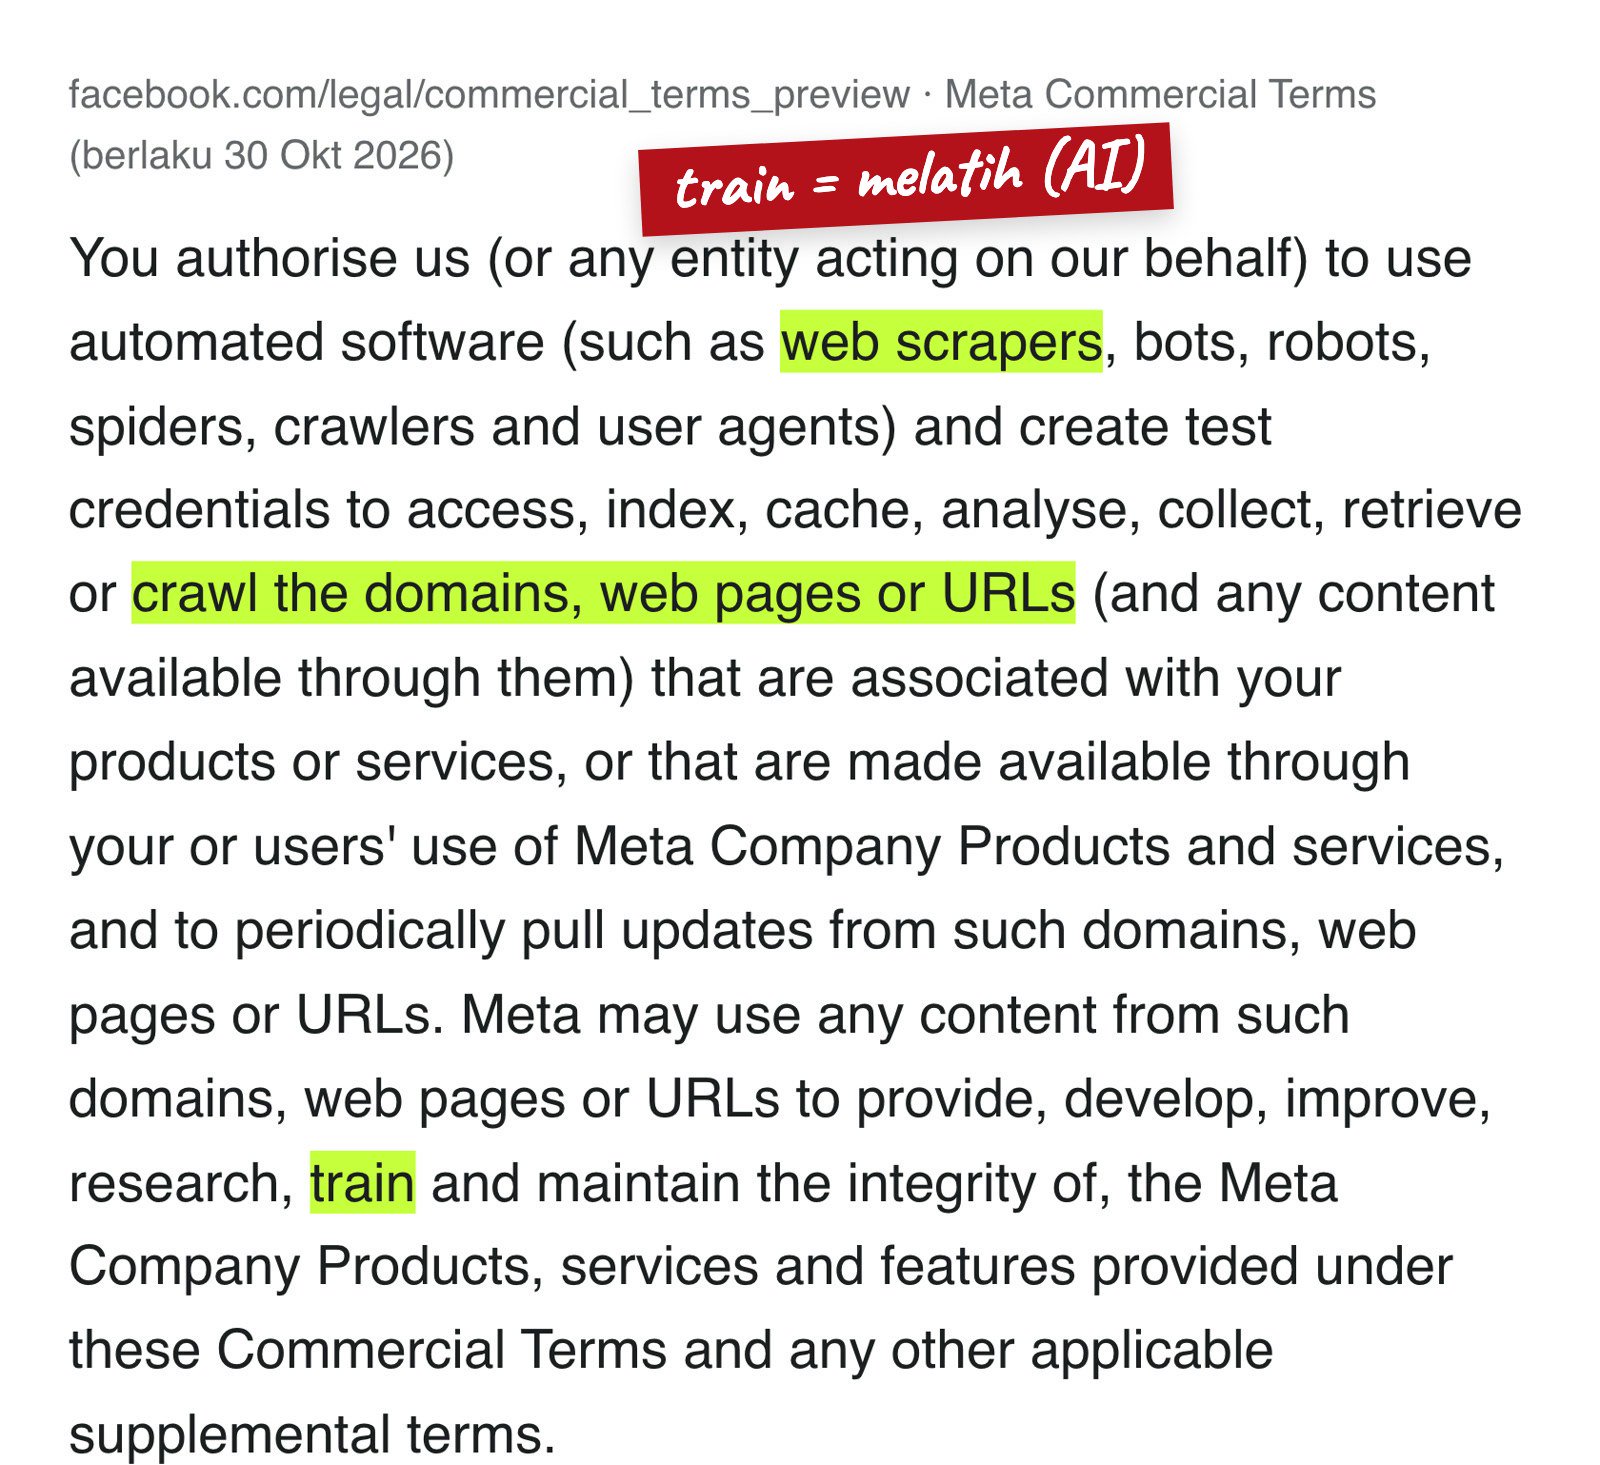
Kami belum tahu apakah ini karena versi tiap bahasa dan wilayah berbeda, atau halamannya belum diperbarui di semua tempat. Kami tulis apa adanya dan akan memperbarui tulisan ini kalau ada kejelasan.
Protes dari media
Sebelum revisi, setidaknya tiga organisasi media sudah bersuara. Dewan Penerbit Eropa berencana meminta Komisi Eropa memeriksa aturan ini. Asosiasi media Inggris menyebutnya perampasan. Di Amerika, News/Media Alliance menilainya "keterlaluan dan kemungkinan melanggar hukum". Di Indonesia, tajuk Kompas 16 Oktober menegaskan karya jurnalistik yang dipakai melatih AI harus dibayar dengan adil.
Yang bisa dilakukan sekarang
Langkahnya sama seperti sebelumnya:
- Cek website mana saja yang tercantum di Page, profil Instagram, katalog, atau iklanmu.
- Minta yang mengurus website memblokir bot Meta lewat robots.txt. Menurut Meta, pilihan itu tetap dihormati.
- Jangan biarkan isi yang kamu jual, seperti materi kursus atau ebook, terbuka bebas tanpa login.