Cara baca benchmark AI: skor tinggi belum tentu cocok buat kerjaanmu
Apa itu benchmark, kenapa angka dari pembuat model perlu dicek ke pihak ketiga, dan kenapa ujian paling penting tetap tugasmu sendiri.
oleh Tim Otaknologi, pagi ini 19.00 · 2 mnt baca
Tiap model AI baru rilis, yang muncul pertama biasanya tabel angka. "72,4%". "Skor 43". "Nomor 1". Angka-angka itu namanya hasil benchmark. Berguna, asal kamu tahu cara bacanya.
Benchmark itu ujian standar
Benchmark adalah kumpulan soal atau tugas yang sama, dipakai untuk menguji banyak model. Mirip ujian nasional: soalnya sama, jadi nilainya bisa dibandingkan.
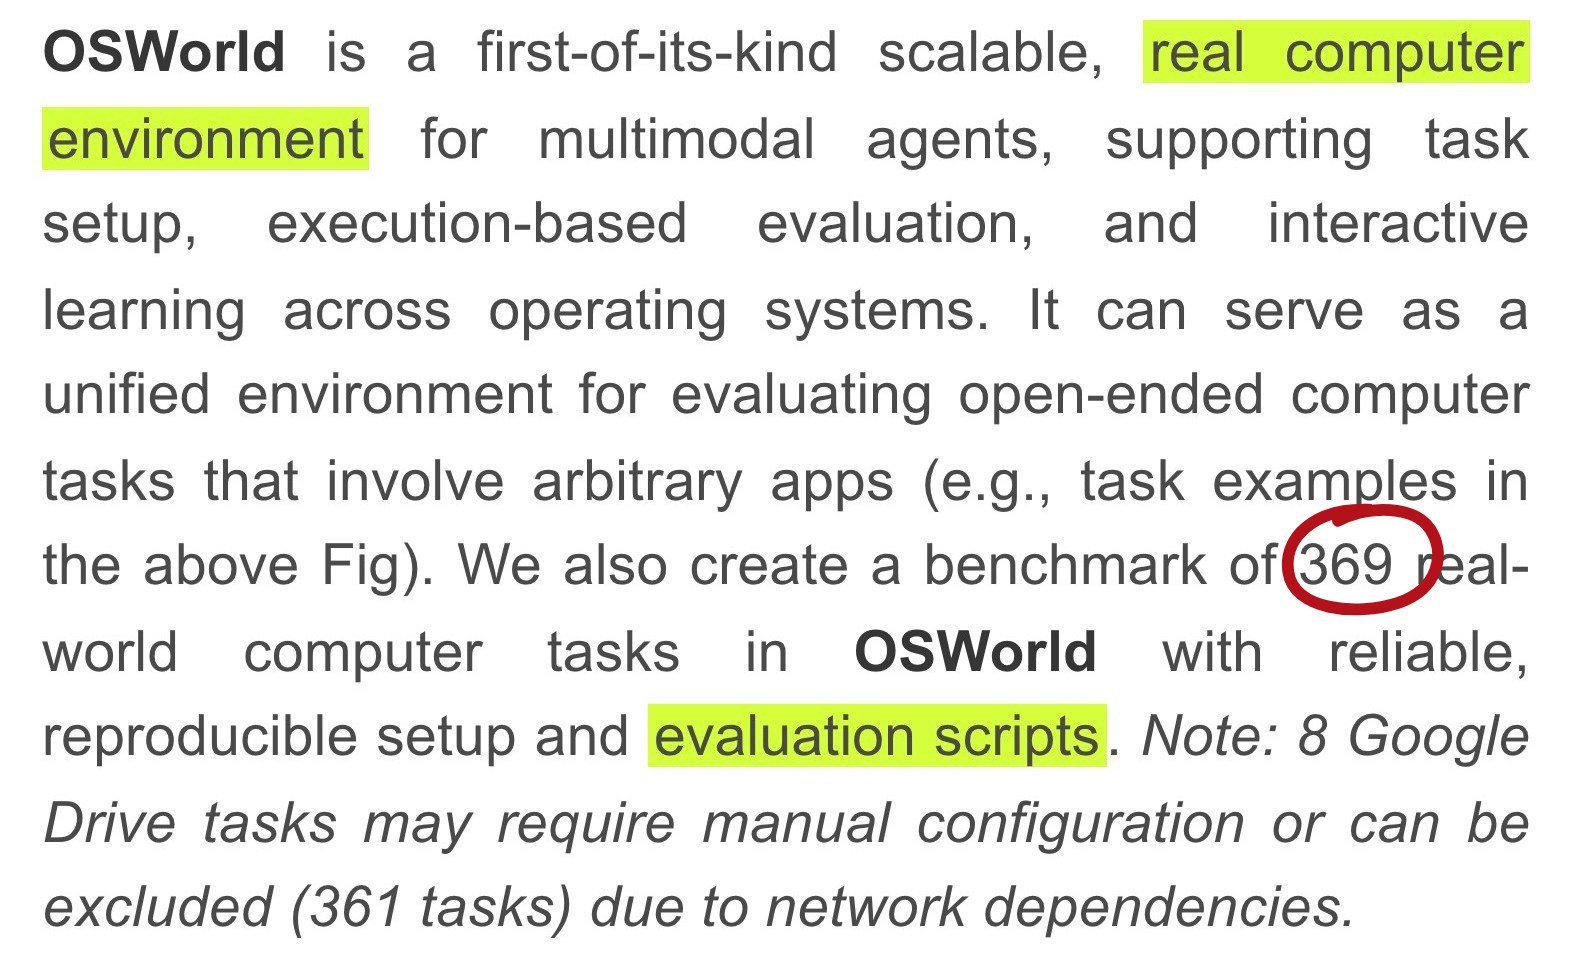
Contohnya OSWorld. Ini ujian yang menyuruh AI mengerjakan tugas di komputer sungguhan, di Ubuntu, Windows, dan macOS. Tugasnya pakai aplikasi web dan desktop asli, dan hasilnya dinilai otomatis oleh skrip. Versi pertamanya berisi 369 tugas.
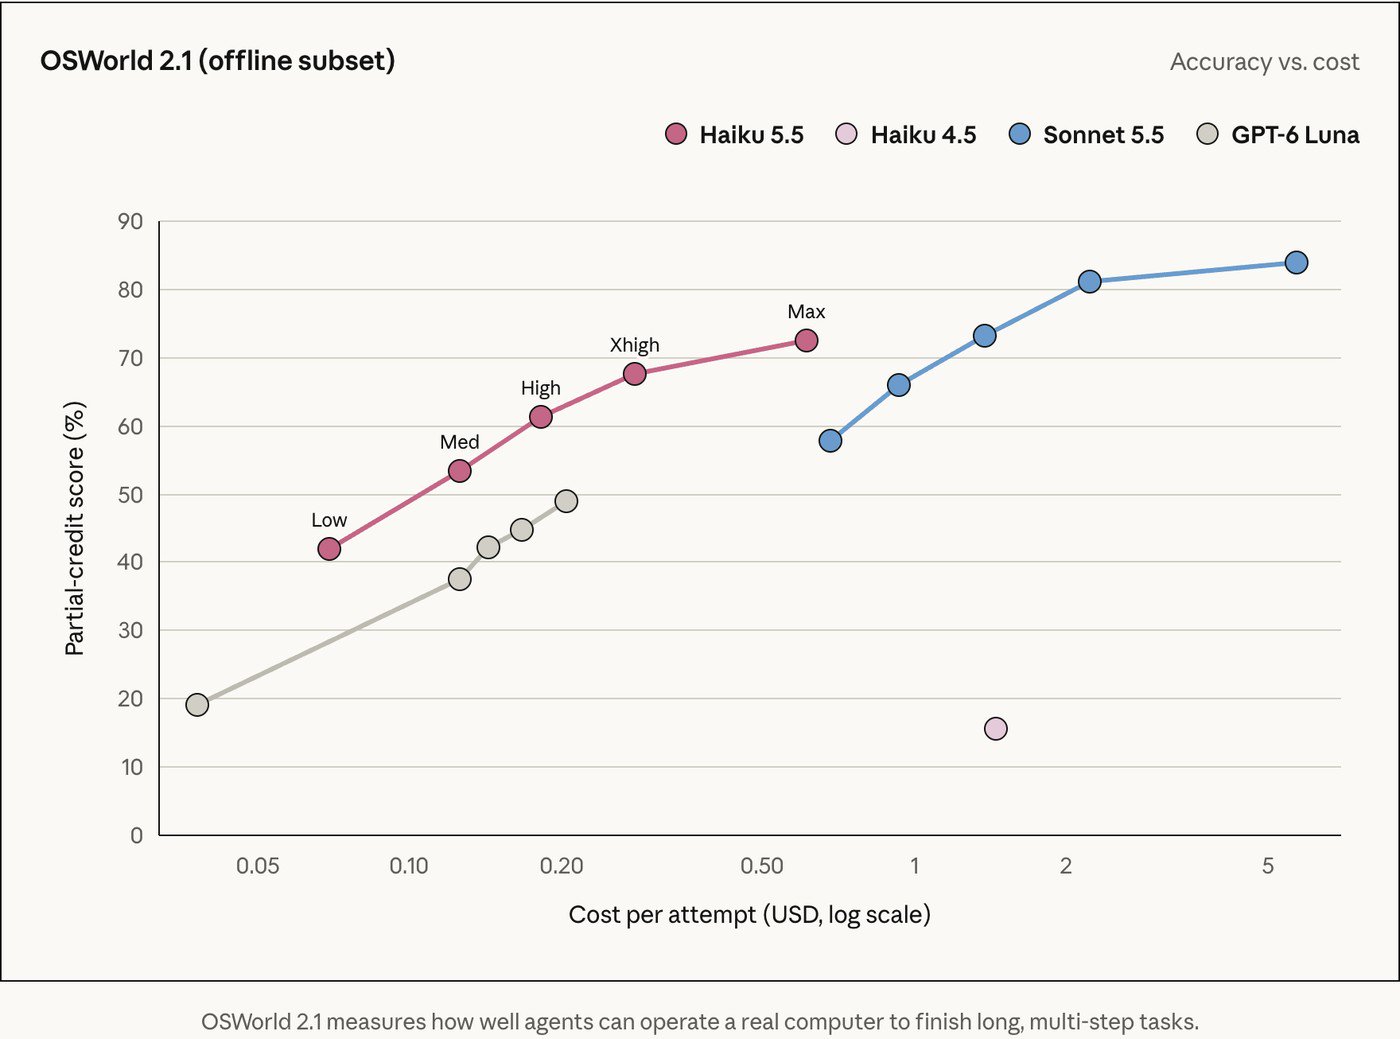
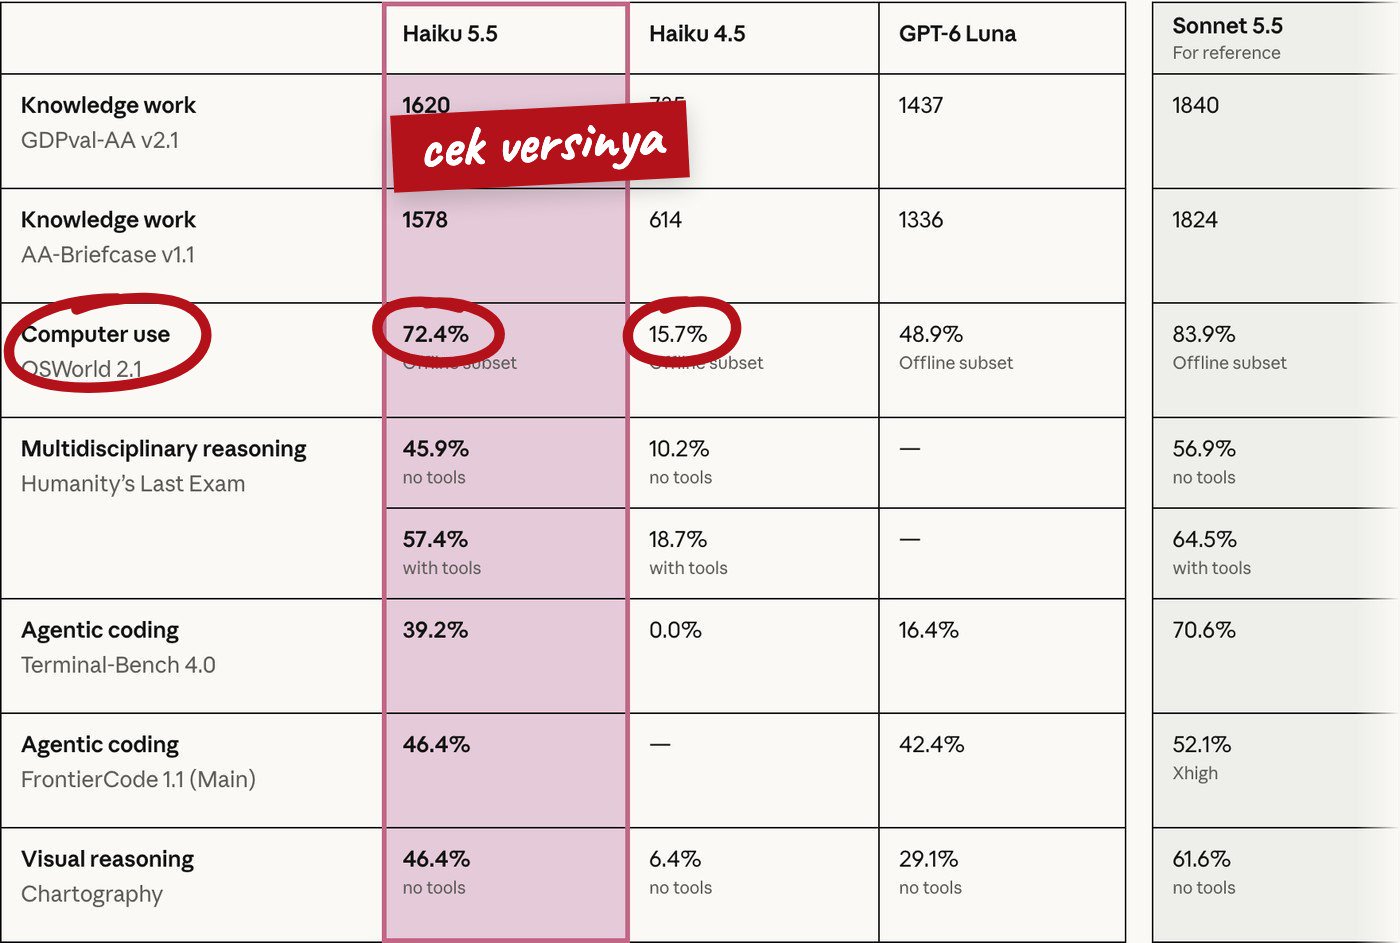
Waktu merilis Claude Haiku 5.5 pada 7 Okt 2026, Anthropic menulis model ini dapat 72,4% di OSWorld 2.1 (subset offline), naik dari 15,7% di Haiku 4.5. Lonjakan besar. Tapi perhatikan dua hal: nama versi ujiannya (2.1, subset offline) dan siapa yang melaporkan (pembuat modelnya sendiri).
Kenapa angka pembuat model perlu dicek
Angka dari pembuat model bukan berarti bohong. Tapi pembuatnya yang memilih ujian mana yang ditampilkan, versi apa, dan dengan setelan apa. Wajar kalau yang dipajang adalah ujian di mana modelnya bersinar.
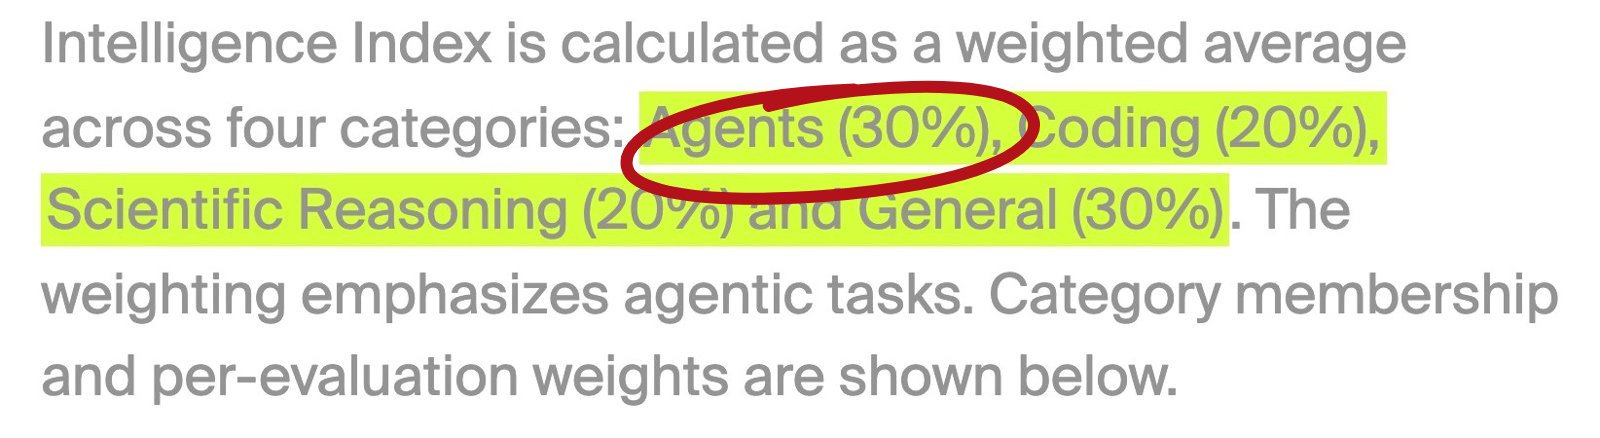
Karena itu, cari pembanding dari pihak ketiga. Salah satunya Artificial Analysis. Mereka menyusun Intelligence Index: nilai gabungan dari 10 evaluasi, dibagi ke empat kategori dengan bobot berbeda (agent 30%, coding 20%, penalaran ilmiah 20%, umum 30%). Kata mereka, semua model dievaluasi dalam kondisi yang sama.
Hasilnya per 10 Okt 2026: Claude Opus 5.5 dapat 58, termasuk skor tertinggi di daftar itu. Haiku 5.5 dapat 43, dan GPT-6 Luna dapat 38. Ketiganya di setelan tertinggi masing-masing.
Kata "setelan" itu penting. Di daftar yang sama, Haiku 5.5 dapat 43 di setelan tertinggi, tapi 29 di setelan terendah. Model yang sama, skornya beda jauh. Jadi kalau kamu lihat satu angka, tanya: ini setelan yang mana?
Skor tinggi belum tentu cocok buat kamu
Ini bagian yang paling sering dilewati. Benchmark mengukur hal tertentu, dengan bobot tertentu. Intelligence Index misalnya memberi bobot besar ke kerja agent dan coding. Kalau kerjaanmu sehari-hari menerjemahkan email klien atau merangkum laporan, skor itu cuma gambaran kasar.
Artificial Analysis sendiri menulis bahwa seperti semua metrik evaluasi, indeks mereka punya keterbatasan dan mungkin tidak berlaku langsung untuk setiap kegunaan. Anthropic juga menulis di panduan memilih model bahwa langkah paling penting adalah punya ujian yang spesifik untuk kasusmu sendiri, lalu menguji dengan prompt dan data aslimu.
Cara baca benchmark dalam 1 menit
- Siapa yang melaporkan? Pembuat model atau pihak ketiga?
- Ujian apa, versi apa? Nama ujian menentukan kemampuan apa yang diukur.
- Setelan apa? Angka terbaik di setelan tertinggi bisa beda jauh dari yang kamu pakai.
- Dibandingkan dengan siapa? Lihat model lama, pesaing yang sekelas harganya, dan pemimpinnya.
- Lalu uji sendiri. Ambil 3 tugas yang paling sering kamu kerjakan, jalankan di beberapa model, nilai hasilnya.
Benchmark itu rapor. Berguna buat menyaring, tapi yang memutuskan cocok atau nggak tetap kamu.