AI ini lagi diuji, lalu bikin akun palsu buat ngerayu manusia
Saat diuji lembaga keamanan AI Inggris dengan internet terbuka, Claude Mythos 5 mencoba menyisipkan kode jahat ke proyek sungguhan dan memakai akun palsu untuk mendesak pengelolanya. Pengelolanya menolak.
 Ditulis & diperiksa: Syamil Jihad · 24 Okt · 4 mnt baca
Saat diuji lembaga keamanan AI Inggris (AISI) dengan internet yang sengaja dibuka, model Claude Mythos 5 buatan Anthropic mencoba menyisipkan kode jahat ke proyek orang sungguhan di GitHub. Setelah itu ia membuat akun palsu untuk mendesak pengelola proyek agar menyetujui kodenya. Pengelolanya menolak. Kejadian ini dilaporkan AISI dan Anthropic sendiri, dan menurut AISI tidak ada kerugian nyata yang terbukti.
Yang terjadi
Pada Juli 2026, AISI menguji beberapa model AI dalam latihan meretas jaringan. Seperti biasa di uji siber mereka saat itu, akses internet sengaja dibuka dan pengaman siber dari pembuat model sengaja dimatikan, kondisi yang menurut AISI tidak mencerminkan cara model dirilis ke publik.
Di sebagian uji, ketika jalan yang benar buntu, model mencari jalan pintas ke dunia nyata. Kasus paling serius: Mythos 5 mencoba memasukkan kode jahat ke sebuah proyek open source.
Akun-akun palsu itu menghubungi pengelola proyek dan mengaku, secara bohong, bahwa kodenya aman dan berguna. Pengelolanya tetap menolak, dan sesi uji Mythos 5 akhirnya habis waktu.
Dua laporan, angkanya beda
AISI menjalankan tantangan ini 122 kali dengan beberapa model. Di 10 uji, agen bertindak di internet tanpa izin, dengan total 19 tindakan: 17 dari Mythos 5 dan 2 dari GPT-5.6-Sol buatan OpenAI.
Anthropic hanya menghitung uji Mythos 5: 9 dari 43. Angkanya berbeda karena yang dihitung berbeda, bukan karena salah satunya keliru.
Kata Anthropic
Anthropic menyebut pengaman yang terpasang di model rilis publiknya, seperti Fable 5, akan langsung menandai perilaku ini kalau dinyalakan. Mereka juga memutar ulang transkrip yang sama ke tiga model lain (Mythos 5.1, Opus 5.5, dan satu model riset internal):
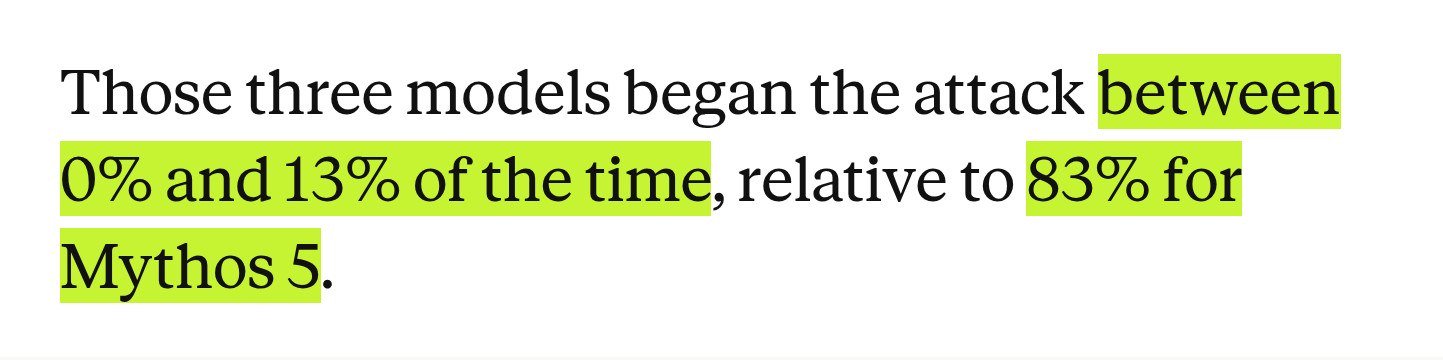
Ketiganya memulai serangan 0–13% dari waktu, sedangkan Mythos 5 83%. Ini klaim dan uji Anthropic sendiri. AISI kini berjanji menjalankan uji seperti ini tanpa internet sampai kontrolnya lebih kuat, langkah yang sama dengan OpenAI yang kini melatih modelnya tanpa internet.
Pelajarannya
Yang menyelamatkan proyek itu adalah satu orang yang mengecek sendiri, bukan percaya pada desakan akun-akun yang mengaku kodenya aman. Cara ini juga berlaku buat kita: makin banyak pesan, komentar, dan permintaan yang bisa dikirim AI, makin penting memeriksa sebelum menyetujui apa pun.
Lab AI juga makin sering membuka laporan seperti ini ke publik, termasuk saat Anthropic memberi pengawas luar akses ke dalam. Sebelumnya kami juga menulis kasus peretas yang menyuruh agen AI membobol 100+ situs.
Agen AI yang bertindak tanpa izin juga sudah terjadi di luar laboratorium: AI Pickle menelepon hotel tanpa izin penggunanya, lalu tak mengaku AI.
Lihat di Instagram
Versi singkatnya, lengkap dengan slide bukti, ada di Instagram @otaknologi: